Software · Vision Defect Detection

Fehlstellen erkennen,
wo Schwellwerte aufgeben.

Entwicklungs- und Pilotangebot: noch kein produktiver Kundeneinsatz. Funktionen und Leistungsziele werden je Anwendung im Pilotprojekt geprüft.

KI-gestützte Oberflächeninspektion für Zeilenkamera-Linien. Das Modell lernt auf Ihren Bildern, unterscheidet natürliche Struktur von echten Defekten und läuft als ONNX-Modell auf Ihrer Steuerung. Kamera, Optik und SPS bleiben, wie sie sind.

So läuft ein Projekt

30 Minuten online: Bringen Sie einige Beispielbilder mit, wir zeigen, was das Modell darauf sieht.

Zeilenkamera · RGB Detektion + Klassifikation ONNX · TwinCAT ML Server Nachtrainierbar im Betrieb
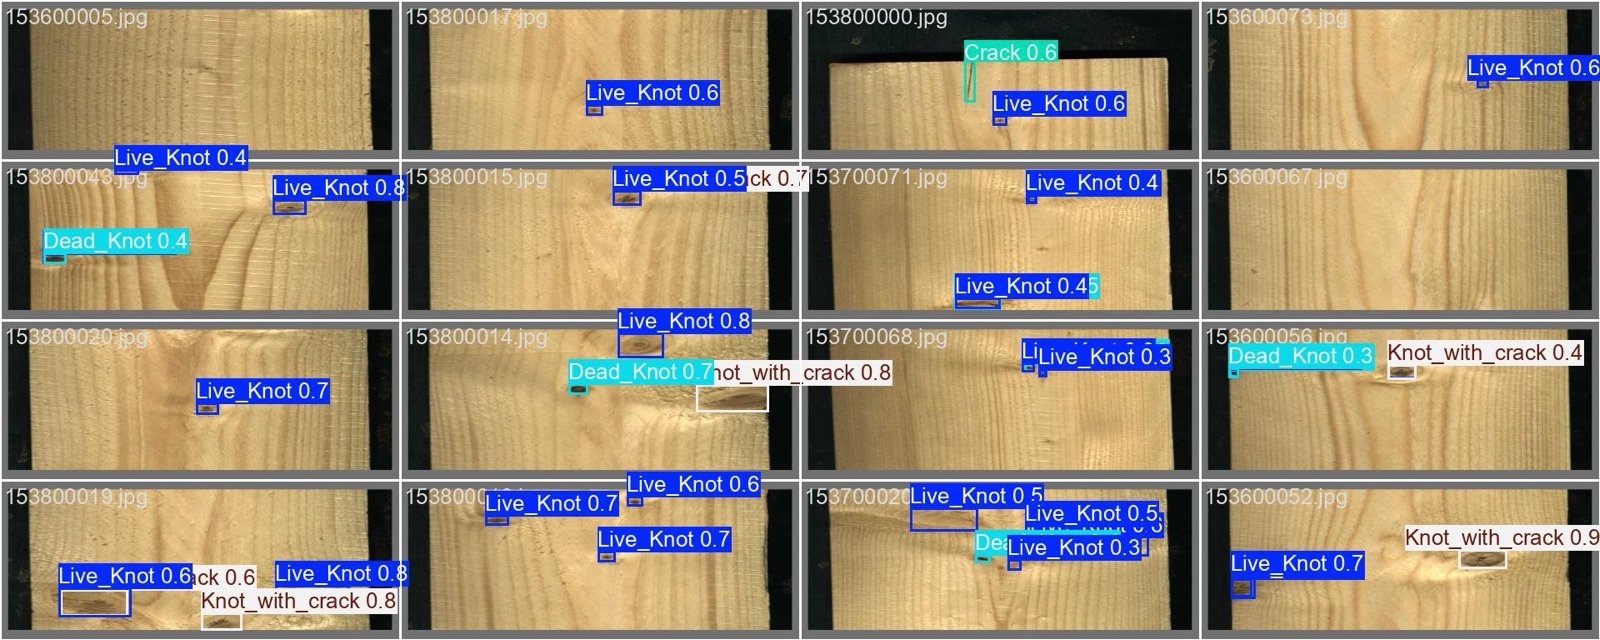
Sechzehn Holzoberflächen mit erkannten Defekten: Äste, tote Äste, Risse und Ast mit Riss, jeweils mit Klasse und Konfidenz markiert
Erkannte Defekte auf Holzoberflächen mit Klasse und Konfidenz, aus der Validierung des Referenzmodells auf einem öffentlichen Datensatz (Kodytek et al. 2022, CC BY 4.0).

Die zweite Stufe hinter Ihrer Bildverarbeitung.

Regelbasierte Systeme erkennen Kontraste. Sie scheitern an dunklen Oberflächen, Wellen, Schatten und an der Frage, ob ein Fleck ein Fehler oder Materialcharakter ist. Vision Defect Detection setzt genau dort an: als gelerntes Modell, das aus Ihren Bildern weiß, was tolerierbar ist und was nicht.

Struktur von Defekt trennen

Maserung, mineralische Einlagerungen und Verfärbungen sind keine Fehler. Das Modell lernt den Unterschied aus gelabelten Beispielen, statt an Schwellwerten zu hängen, die bei jedem Lichtwechsel neu justiert werden müssen.

Läuft auf Ihrer Hardware

Ausgeliefert als ONNX-Modell für den TwinCAT ML Server oder einen Industrie-PC mit GPU. Keine Cloud, keine Bilddaten, die das Werk verlassen. Zeilenkamera, Objektiv und SPS bleiben im Einsatz.

Wird im Betrieb besser

Grenzfälle mit niedriger Konfidenz werden gesammelt, ein Prüfer entscheidet Stichproben, das Modell wird periodisch nachtrainiert. Ab der zweiten Runde übernimmt das Modell selbst das Vorlabeln.

Wo regelbasierte Systeme an Grenzen stoßen

  • Dunkle Oberflächen, auf denen Schwellwerte nicht mehr greifen
  • Wellen und Höhenunterschiede, deren Schatten als Defekt gemeldet werden
  • Beleuchtungsschwankungen, die jedes Mal eine neue Kalibrierung erzwingen
  • Natürliche Struktur, die sich von echten Fehlern regelbasiert kaum trennen lässt
  • Grauzonen zwischen tolerierbarem und kritischem Defekt, die heute ein Mensch entscheidet

Die Folge ist bekannt: viele Fehlalarme bei gutem Material, übersehene Defekte bei schwierigem. Ein gelerntes Modell dreht das Verhältnis um und liefert für jeden Fund eine Klasse, eine Position und eine Konfidenz.

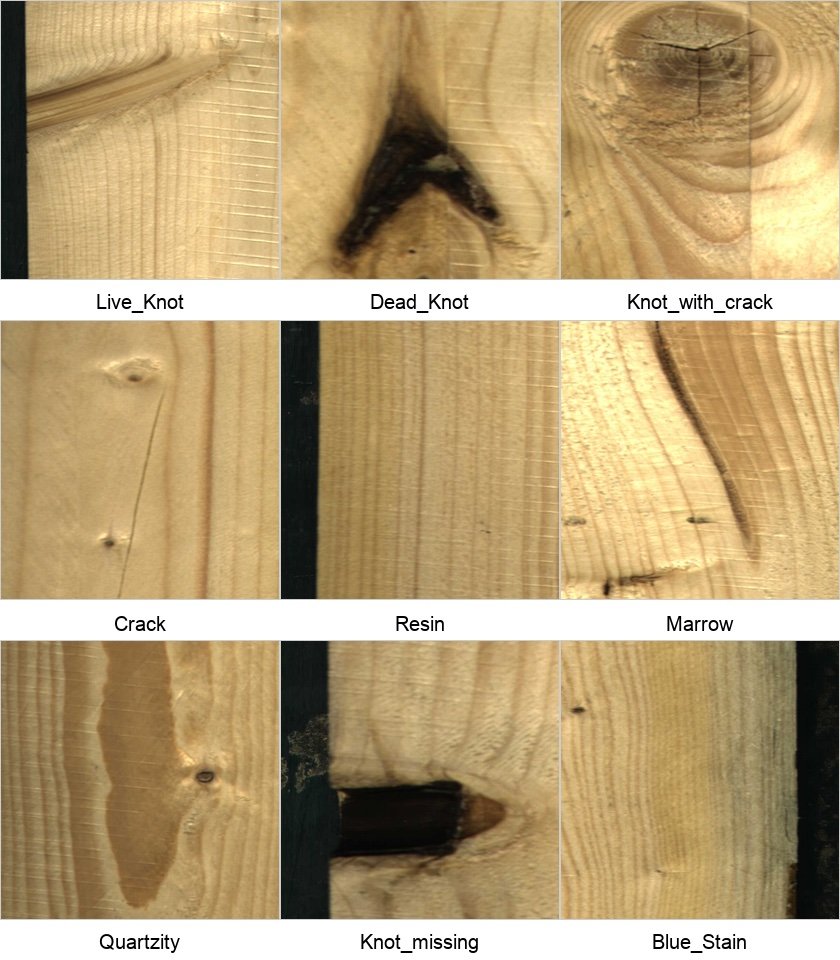
Neun Beispielausschnitte von Holzdefekten: lebender Ast, toter Ast, Ast mit Riss, Riss, Harz, Mark, Quarzigkeit, fehlender Ast, Blaufäule
Defektklassen, wie sie das Modell unterscheidet. Beispiel Holz: Äste, Risse, Harz, Mark, fehlende Äste, Verfärbungen. Das Klassenschema wird je Anwendung mit Ihren Prüfern festgelegt.

Von Ihren Bildern zum Modell auf der Linie

Fünf Schritte mit klaren Übergaben. Jeder Schritt endet mit einem Ergebnis, das Sie prüfen können.

1

Bilder

Die Zeilenkamera läuft im Normalbetrieb mit. Wichtig ist Vielfalt: alle Materialvarianten, alle Defektarten, auch fehlerfreie Teile. Eine automatische Eingangsprüfung sortiert Duplikate und defekte Dateien aus.

2

Labeln

Ein Referenzmodell schlägt Boxen und Klassen vor, Ihre Prüfer korrigieren nur noch. Das dauert Sekunden statt Minuten pro Bild und hält das Domänenwissen bei Ihnen.

3

Trainieren

Transfer Learning auf GPU-Rechnern in der EU, ausgehend von einem Modell, das Oberflächen bereits kennt. Modellgröße nach Genauigkeit und Latenz auf Ihrer Zielhardware gewählt.

4

Prüfen

Evaluation gegen die Abnahmekriterien aus Ihrem Lastenheft: Erkennungsrate je Defektklasse, Fehlalarmrate, Konfusionsmatrix, Rechenzeit. Schwächen werden benannt, nicht versteckt.

5

Ausliefern

ONNX-Export, Paritätsprüfung gegen das Trainingsmodell, Spezifikation für Ihren Integrator und Referenzcode für die Zuordnung zur Qualitätsklasse.

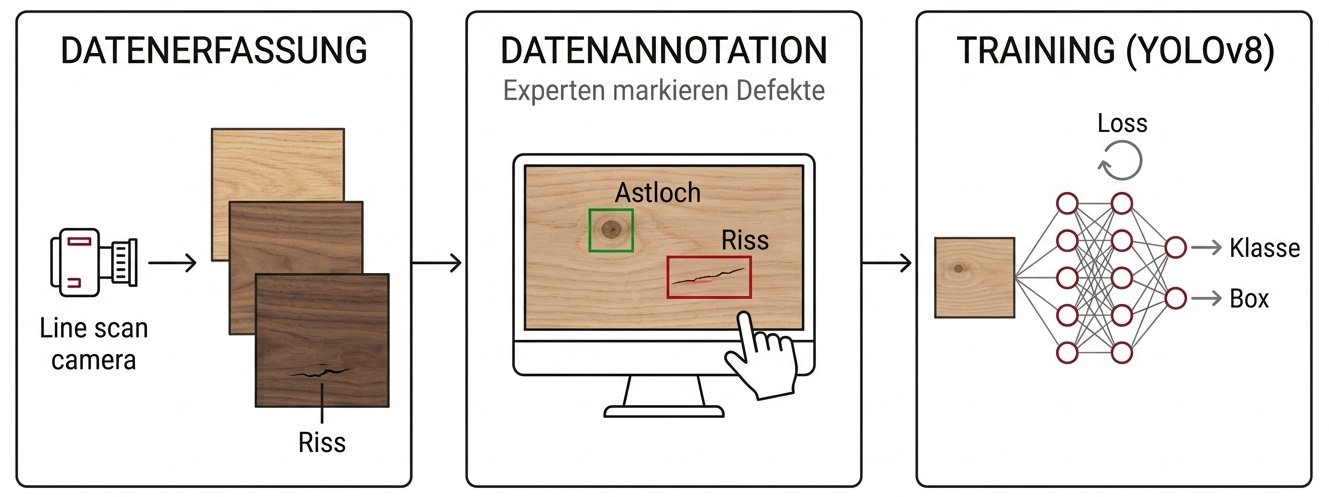
Ablaufdiagramm: Datenerfassung mit Zeilenkamera, Datenannotation durch Experten, Training eines neuronalen Netzes mit Ausgabe von Klasse und Box
Überwachtes Lernen in drei Stationen: erfassen, annotieren, trainieren. Das Ergebnis liefert je Fund Klasse und Position.

Was Sie in der Hand halten

Kein Forschungsbericht, sondern ein Paket, das Ihr Integrator direkt verbauen kann. Jeder Bestandteil ist dokumentiert und versioniert.

  • ONNX-Modell mit fester Ein- und Ausgabespezifikation, geprüft auf identische Ergebnisse gegenüber dem Trainingsmodell
  • Evaluationsbericht mit Kennzahlen je Defektklasse, Konfusionsmatrix, Lernkurven und Fehleranalyse
  • Regelwerk-Referenz: Defektliste zu Qualitätsklasse, als Vorlage für die Umsetzung in der SPS, von Ihren Bedienern konfigurierbar
  • Continual-Learning-Konzept: Sammlung der Grenzfälle, Nachtrainingszyklus, Versionierung von Modell und Datensatz, Rollen bei Ihnen
  • Label-Werkzeugkette mit Vorlabel-Dienst, betrieben bei Ihnen oder bei uns, damit Nachtraining ohne Neuanfang möglich ist
Auszug Modellspezifikation Beispiel · Referenzmodell
MerkmalWert
FormatONNX, Opset 12, kompatibel mit TwinCAT ML Server (TF3820)
Eingabe[1, 3, 768, 768] RGB, normiert auf 0 bis 1
AusgabeDefektliste je Bild: Klasse, Position, Größe, Konfidenz
ArchitekturEinstufiger Detektor (YOLO-Familie), Modellgröße nach Latenzziel
ZielhardwareBeckhoff IPC, optional GPU · Ziel unter 200 ms je Bild
NachtrainingAus Grenzfällen des Betriebs, versioniert, ohne Neuaufbau

Werte des Referenzmodells. Auflösung, Klassen und Latenzziel werden je Anwendung im Pflichtenheft festgelegt.

20.000+

Bilder im Referenztraining

0,82–0,87

mAP50 der Hauptklassen

< 2 GPU-h

je vollständigem Trainingslauf

Referenzmodell auf dem öffentlichen Datensatz von Kodytek et al. (2022). Werte auf Ihren Daten hängen von Bildmenge, Klassenbalance und Defektvarianz ab.

Für wen

Erster Anwendungsfall ist Holz und Furnier. Das Verfahren ist materialunabhängig: Alles, was eine Zeilenkamera sieht und ein Prüfer beurteilen kann, lässt sich lernen.

Produzenten mit Inspektionslinie

Sie haben Zeilenkamera und Bildverarbeitung im Einsatz und stoßen an deren Grenzen. Das Modell wird auf Ihren Bildern trainiert, die Qualitätsklassen legen Ihre Prüfer fest, das Ergebnis läuft auf Ihrer Steuerung.

Anlagenbauer und Integratoren

Sie liefern Inspektionsanlagen und wollen eine KI-Stufe im Angebot, ohne ein ML-Team aufzubauen. Wir liefern Modell, Spezifikation und Werkzeugkette, Sie integrieren unter Ihrer Marke.

Beckhoff- und TwinCAT-Umgebungen

Die eingebauten ML-Funktionen von TwinCAT Vision importieren kein ONNX. Wir liefern für den TwinCAT ML Server, mit Function-Block-Konzept und Integrationsabstimmung, damit das Modell in der SPS-Zykluskette läuft.

Machbarkeit, Produktivmodell, Pflege

Drei Stufen, die aufeinander aufbauen. Der Einstieg ist klein und liefert eine Zahl, bevor Sie sich festlegen.

Einstieg

Machbarkeitscheck

Erstes Modell auf einer Teillieferung Ihrer Bilder, gelabelt mit Vorlabel-Unterstützung. Sie erhalten Kennzahlen je Defektklasse und eine ehrliche Einschätzung, ob sich das Produktivmodell lohnt und welche Bilder noch fehlen.

Projekt

Produktivmodell

Klassenschema und Pflichtenheft, Labeling-Workflow, kuratierter Datensatz, Training und Evaluation, ONNX-Export mit Spezifikation und Integrationsbegleitung. In Arbeitspaketen mit Meilensteinen, zum Festpreis.

Betrieb

Modellpflege und Lizenz

Nutzungslizenz je Linie, periodisches Nachtraining aus den Grenzfällen des Betriebs, Versionierung von Modell und Datensatz, neue Materialvarianten und Klassen ohne Neuanfang.

Gemessen, nicht versprochen.

Die Pipeline ist auf einem öffentlichen Datensatz mit über 20.000 Bildern und zehn Defektklassen durchgängig validiert: Training, Evaluation, ONNX-Export und Paritätsprüfung. Was auf Ihren Daten erreichbar ist, sagen wir nach dem Machbarkeitscheck mit Zahlen und benennen die Grenzen dazu.

  • Abnahmekriterien in ML-Sprache: Erkennungsrate struktureller Defekte als Recall, Fehlalarmrate als Precision, Latenz auf der Zielhardware. Ihr Lastenheft wird eins zu eins messbar.
  • Wenig Daten, trotzdem Start: Erprobte Augmentierung für seltene Defektklassen, damit auch eine kleine oder unausgewogene Bildlieferung ein erstes Modell trägt.
  • Daten bleiben bei Ihnen: Training auf GPU-Rechnern in der EU, Inferenz im Werk. Rohbilder und Modell bleiben Ihr Eigentum, veröffentlicht wird nichts ohne Ihre Zustimmung.
  • Beleuchtung ehrlich eingeordnet: Kein Modell rettet harte Schatten und Überbelichtung. Wo die Aufnahme das Problem ist, sagen wir es und geben die Empfehlung an den Hardware-Integrator weiter.
Entwicklung und Verantwortung
Prof. Dr.-Ing. Andreas Unger

Prof. Dr.-Ing. Andreas Unger

Professor für Mechatronik und Automatisierung, Forschung an der Schnittstelle von Sensorik, Simulation und maschinellem Lernen. Vision Defect Detection ist seine Entwicklung; Vision Squared ist Lizenzgeber und Ansprechpartner. Der Quellcode bleibt geschlossen.

Referenzen

Entwicklungsstand und Referenzmodell erläutern wir im Gespräch. Ergebnisse aus nichtproduktiven Partnerpiloten nennen wir nur, soweit sie tatsächlich vorliegen und vom Partner freigegeben sind.

Über Vision Squared

Häufige Fragen

Gibt es eine Demo?

Keine öffentliche Demo. Im Online-Termin lassen wir das Referenzmodell auf Beispielbildern laufen, gern auf Ihren eigenen. Sie sehen Boxen, Klassen und Konfidenzen live und bekommen eine erste Einschätzung, wie weit das Modell bei Ihrem Material trägt.

Wie viele Bilder brauchen wir?

Für ein Produktivmodell einige tausend Bilder aus dem Normalbetrieb, mit allen Materialvarianten, allen Defektarten und einem Anteil fehlerfreier Teile. Für den Machbarkeitscheck reichen einige hundert. Entscheidend ist die Vielfalt, nicht die Perfektion der Einzelbilder.

Müssen wir neue Kameras kaufen?

Nein. Zeilenkamera, Objektiv und Steuerung bleiben. Für die Inferenz auf einer Beckhoff-Steuerung ist der TwinCAT ML Server als Lizenz nötig, bei hohen Taktraten ein Industrie-PC mit GPU. Die Hardwareempfehlung stimmen wir mit Ihrem Integrator ab. Nur die Beleuchtung ist manchmal der eigentliche Engpass, das sagen wir Ihnen früh.

Wo werden unsere Bilder verarbeitet?

Das Training läuft auf GPU-Rechnern in der EU, das fertige Modell im Werk auf Ihrer Hardware. Es gibt keinen Cloud-Dienst im Betrieb und keine Bilder, die die Linie verlassen. Rohdaten und trainiertes Modell bleiben Ihr Eigentum.

Ist die Software Open Source?

Nein. Pipeline, Vorlabel-Dienst und Werkzeugkette bleiben bei Vision Squared und werden lizenziert. Das trainierte Modell und Ihre Daten gehören Ihnen. So bleibt klar, wer für Methode und Weiterentwicklung verantwortlich ist.

Funktioniert das auch außerhalb von Holz?

Ja. Das Verfahren lernt aus gelabelten Bildern, nicht aus Materialwissen. Bleche, Textilien, Folien, Platten und Bauteiloberflächen sind mit derselben Pipeline machbar. Der Machbarkeitscheck zeigt, wie gut Ihr Material und Ihre Defektklassen trennbar sind.

Zeigen Sie uns Ihre schwierigsten Bilder.

Ein Gespräch von 30 Minuten: Ihre Linie, Ihre Defektklassen, Ihre Fehlalarme. Bringen Sie ein paar Beispielbilder mit. Danach wissen Sie, ob der Machbarkeitscheck der nächste Schritt ist.

Nachricht schreiben